文字起こしテキストからGhostドラフトを自動作成する方法 ― OpenAI APIで記事と画像を生成
音声を文字起こししたテキストファイルから、記事生成、重複確認、feature image作成、Ghostへのドラフト投稿までを自動化する流れを解説します。
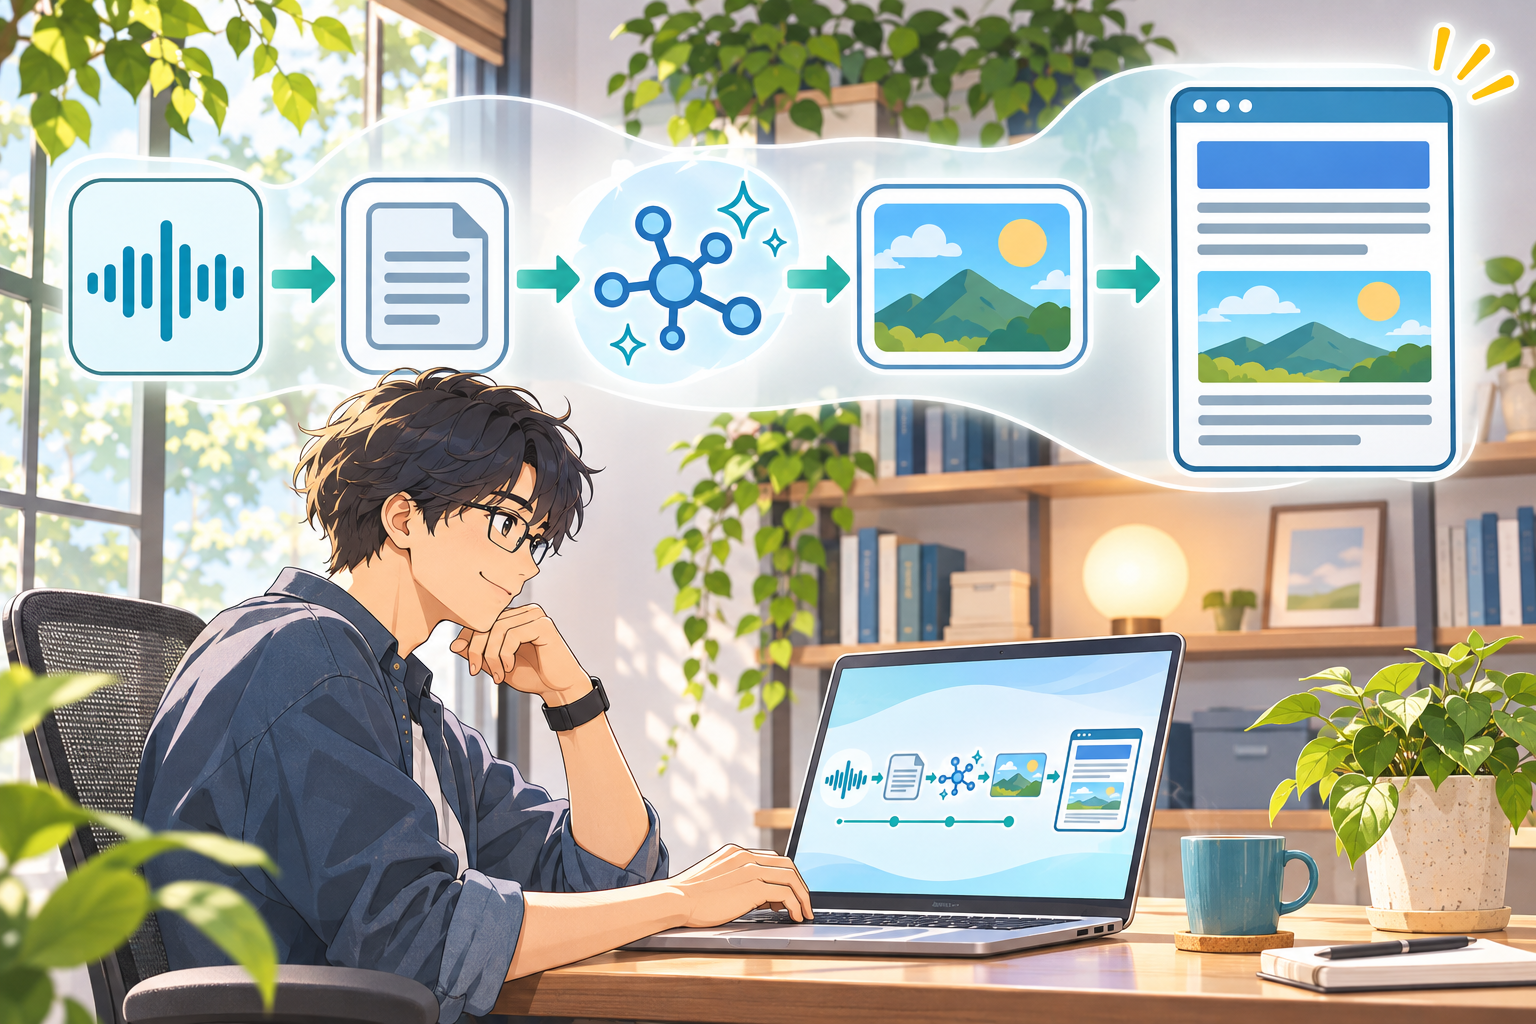
音声の中には、会議で自然に使われた言い回しや、教科書だけではつかみにくいニュアンスが数多く含まれています。文字起こし済みのテキストを活用すれば、そこから学習価値の高い英会話フレーズを選び、解説を付け、ブログの下書きまで自動で用意できます。
この記事では、特定の音声管理アプリには依存せず、文字起こしテキスト(.txt)を入口にして、記事本文・一意なURL・feature imageを生成し、Ghostへドラフト投稿する汎用的な流れを紹介します。公開操作は自動化せず、最後は人が内容を確認できる設計です。
全体像:テキストファイルからGhostドラフトまで
音声ファイル
  ↓ 任意の音声認識ツール
文字起こしテキスト(.txt)
  ↓ 選択・整形・匿名化
OpenAI APIで記事案を構造化生成
  ↓ タイトル・slug・本文・タグ
過去履歴と照合して重複を回避
  ↓
記事テーマに合わせたfeature imageを生成
  ↓ 画像をGhostへアップロード
Ghost Admin APIでdraft投稿
この構成のポイントは、音声認識部分と記事生成部分を分離することです。文字起こし結果さえテキストファイルとして保存されていれば、録音アプリや音声認識サービスを変更しても、後段の処理をほぼそのまま利用できます。
開発者向け:作成したファイルとプログラムの構成
ここからは、今回の自動化をどのようなプログラムへ分割したかを、実装寄りに説明します。実装言語はTypeScript、実行環境はNode.jsです。ひとつの大きなスクリプトへすべてを書かず、入力、記事生成、重複管理、画像生成、Ghost連携を別々のモジュールへ分けました。これにより、文字起こし方法やブログサービスを変更するときも、影響する部分だけを交換できます。
主なファイル構成
src/
├── config.ts                    # 環境変数の読み込みと検証
├── english-source-sanitizer.ts  # 原文をローカルで分類・最小化
├── english-post.ts              # 記事Schema、検証、重複判定、HTML生成
├── english-post-job.ts          # 一連の処理を実行するオーケストレーター
├── english-history.ts           # 生成履歴の読み書き
├── english-feature-image.ts     # feature imageのプロンプト生成と画像生成
├── openai-client.ts             # OpenAI API呼び出し
├── ghost-client.ts              # Ghost認証、画像アップロード、draft作成
└── cli.ts                       # コマンドラインの入口

test/
├── english-post.test.ts
├── english-post-job.test.ts
├── english-feature-image.test.ts
├── english-source-sanitizer.test.ts
└── ghost-client.test.ts

docs/systemd/
└── transcript-english-post.service  # PC起動時に実行するサービス例
各モジュールの役割
config.tsは、APIキー、使用モデル、1記事あたりのフレーズ数、文字起こしから抽出する最大文字数、画像サイズなどを環境変数から読み込みます。数値や画像サイズのような設定値は起動時に検証し、不正な設定のままAPIを呼び出さないようにしています。
english-source-sanitizer.tsは、文字起こし原文をローカルで解析し、「会議」「日程調整」「進捗報告」などのシーンと、「確認」「依頼」「フォローアップ」などの会話目的へ変換します。OpenAIへ渡すのはこの分類結果であり、氏名や会社名を含む文字起こし原文は渡しません。入力データと外部APIの間に明確な境界を設けるためのモジュールです。
english-post.tsには、OpenAIから受け取るJSON Schema、記事データのパース、タグの正規化、フレーズの重複判定、タイトルとslugの一意性確認、Ghostへ渡すHTMLの組み立てを集約しています。生成AIの出力をそのまま信用せず、必須項目やフレーズ数を通常のプログラムでも検証する設計です。
english-post-job.tsは処理全体の司令塔です。文字起こしの選択、ローカル分類、記事生成、最大3回の再生成、feature image生成、Ghostへの投稿、履歴更新を順番に実行します。画像生成だけが失敗した場合は理由をログへ残し、画像なしでも記事ドラフトの作成を続けます。一方、Ghostへの投稿に失敗した場合は履歴を更新しないため、「投稿されていないのに使用済みになる」状態を防げます。
english-history.tsは、使用した英語フレーズ、タイトル、base slug、最終slug、Ghost投稿IDなどをJSONへ保存します。書き込み途中の破損を避けるため、いったん一時ファイルへ書き込み、その後renameで置き換えます。
english-feature-image.tsは、記事のシーンから画像用プロンプトを組み立て、横長の画像を生成します。文字起こし原文は画像生成にも送信しません。ghost-client.tsはGhost Admin API用の短時間JWTを生成し、画像をmultipart/form-dataでアップロードしてから、返されたURLをfeature_imageへ設定した記事をdraftとして登録します。
.txtを入力にする場合のアダプター
現在の実装では、タイムスタンプ付きの文字起こしを再利用できるよう、内部的にはtextとsegmentsを持つJSONを読み込みます。ただし、記事生成処理が必要とするのは最終的に文字列だけです。汎用版では、次のような小さな入力アダプターを用意すれば、任意の文字起こし.txtを同じ処理へ渡せます。
import { readFile } from "node:fs/promises";
import { basename } from "node:path";

async function loadTranscriptText(filePath: string) {
  const text = (await readFile(filePath, "utf8")).trim();
  if (!text) throw new Error("文字起こしファイルが空です");

  return {
    audioId: basename(filePath, ".txt"),
    text,
    segments: []
  };
}
音声認識ツールは、OpenAI Whisper、ローカルWhisper、スマートフォンの文字起こし機能など、どれでも構いません。UTF-8のテキストへ変換できれば、後段の処理は同じです。タイムスタンプが必要になったときだけ、segmentsを持つ形式へ拡張できます。
プログラムの実行フロー
1. 入力フォルダから文字起こしをランダムに選択
2. 長い文章から上限文字数以内の範囲をランダム抽出
3. ローカルでシーンと会話目的を分類
4. 過去のフレーズ・タイトル・slugを履歴から読み込む
5. Structured Outputsで記事データを生成
6. 必須項目、直接引用、重複をローカル検証
7. 問題があれば条件を追加して再生成(最大3回)
8. 日付付きの一意なslugを確定
9. 記事HTMLとfeature imageを生成
10. Ghostへ画像をアップロード
11. Ghostへstatus=draftで記事を作成
12. 成功後にだけ履歴を保存コマンドには、Ghostへ投稿せず生成結果だけを確認する--dry-runも用意します。最初にプレビューでプロンプト、記事本文、画像プロンプトを確認してから、本番のドラフト作成を実行できるようにしています。
# 投稿せずに記事を確認
npm run preview:english-post

# TypeScriptをビルド
npm run build

# Ghostへドラフトを1件作成
npm run generate:english-post
長時間の文字起こしは使い捨てにしない
長時間録音の文字起こしには、1本の中に複数の会議場面や会話目的が含まれます。そのため、1回記事を作っただけでソース全体を「使用済み」にはしません。実行のたびに文字起こしファイルと開始位置をランダムに選び、設定された上限文字数だけを抽出します。同じ録音を何度も参照しながら、異なる場面を記事化できます。
履歴で重複判定するのは、生成したフレーズ、タイトル、base slug、最終slugです。sourceAudioIdも記録しますが、これは出典を追跡するための情報であり、次回の候補から除外する目的には使いません。ただし、現在は使用済みの開始位置と終了位置までは管理していないため、抽出範囲が一部重なる可能性があります。より均等に全体を活用したい場合は、文字起こしをチャンク化し、チャンクIDと利用回数を履歴へ追加する方法が適しています。
主な環境変数
OPENAI_API_KEY=...
GHOST_ADMIN_API_KEY=...
GHOST_URL=https://example.com

ENGLISH_POST_MODEL=...
ENGLISH_POST_PHRASE_COUNT=2
ENGLISH_POST_MAX_SOURCE_CHARS=6000
ENGLISH_POST_FEATURE_IMAGE_ENABLED=true
ENGLISH_POST_IMAGE_MODEL=...
ENGLISH_POST_IMAGE_SIZE=1536x1024
ENGLISH_POST_IMAGE_QUALITY=medium.envには秘密情報が含まれるため、Gitへ登録しません。ログへAPIキーや文字起こし原文を出力しないようにします。
テストで確認するポイント
生成AIを利用する処理でも、API以外の部分は通常の自動テストで検証できます。OpenAIとGhostの通信はモックへ置き換え、次の振る舞いを確認します。
- フレーズが必ず2つで、自然な返答例を含むこと
- 句読点や大文字・小文字が違っても同じフレーズを重複と判定すること
- タイトルとslugの重複時に再生成されること
- 日付付きslugが衝突した場合に連番が付くこと
- 原文の長い直接引用を拒否すること
- Ghostへ
status=draft、タグ、feature imageが正しく送られること --dry-runでは投稿も履歴更新も行わないこと
モジュールを小さく分けておくと、生成モデル、画像モデル、入力形式、投稿先を将来変更しても、回帰テストで既存機能を守りながら置き換えられます。
1. 入力は文字起こし済みの.txtに統一する
入力用フォルダへ、UTF-8のテキストファイルを保存します。ファイル名には日付や用途を含めると、トラブル時の追跡が容易です。
transcripts/
├── 2026-11-01-team-meeting.txt
├── 2026-11-03-client-call.txt
└── 2026-11-07-project-review.txt
定期実行時には、ファイルから1件をランダムに選びます。ただし、完全なランダム選択だけでは同じ話題が続くことがあるため、「直近に使ったファイルを除外する」「シーン分類が連続しないようにする」といった条件を組み合わせると記事の偏りを抑えられます。
2. APIへ渡す前に匿名化と最小化を行う
文字起こしには、氏名、会社名、顧客情報、案件名などが混ざる可能性があります。原文をそのまま外部APIへ送るのではなく、ローカル処理で固有名詞を置換し、学習に必要な発話部分だけを切り出します。
田中さん、A社の新契約は金曜日までに確認できますか?
↓
[担当者]、[顧客企業]の契約は期限までに確認できますか?
さらに、1回に送る文字数へ上限を設け、電話番号・メールアドレス・URLなどを機械的に除去します。記事の題材として不要な情報を送らない「データ最小化」は、コスト削減にも入力品質の安定にも役立ちます。
3. 記事案は構造化データとして生成する
モデルに自由な文章だけを返させると、見出しの不足やタグ形式の揺れが起きやすくなります。そこで、タイトル、slug、概要、2つのフレーズ、タグなどをJSON Schemaで定義し、構造化して受け取ります。OpenAIのStructured Outputsは、指定したJSON Schemaに沿った出力を得るための仕組みです。
{
  "title": "会議の進捗確認で使える英語表現:代表フレーズ",
  "slugBase": "meeting-progress-phrases",
  "excerpt": "記事の短い説明",
  "scene": "Project meeting",
  "phrases": [
    {
      "phrase": "Where do we stand on this?",
      "meaningJa": "これは現在どの段階ですか?",
      "nuance": "進捗を簡潔に確認する表現",
      "grammar": "where + do + 主語 + stand",
      "example": "Where do we stand on the contract review?",
      "response": "We're almost done. I'll send it this afternoon.",
      "responseJa": "ほぼ完了です。今日の午後に送ります。"
    }
  ],
  "tags": ["English", "Business English", "Meetings"]
}生成後は、フレーズ数が必ず2つか、英語と日本語が空でないか、先頭タグがEnglishかなどをアプリ側でも検証します。検証に失敗した場合だけ再生成することで、記事ごとの品質をそろえられます。
4. フレーズだけでなく「言われた側」の返答も載せる
会話は一方向ではありません。各記事ではフレーズを2つに絞り、それぞれに次の要素を持たせます。
- よく使われる英語フレーズ
- 日本語の意味
- ネイティブが感じるニュアンス
- 文法・語句のポイント
- 実際の場面を想定した例文
- その言葉を受けた人の自然な返答
- 返答の和訳と使い分け
たとえば、“Could you walk me through it?” に対して、“Sure. Let me start with the overall process.” のような返答をセットにします。問いかけと受け答えを一緒に覚えられるため、読むだけの記事よりも実際の会話へ移しやすくなります。
5. タイトル・フレーズ・slugの重複を三段階で防ぐ
毎日自動生成する仕組みでは、重複防止が重要です。ローカルに生成履歴を保存し、Ghost上の既存記事とも照合します。
- 英会話フレーズを小文字化し、空白や句読点を正規化して過去履歴と比較する
- タイトルとslugが既存記事に存在する場合は、別の代表フレーズやシーンを使って再生成する
- 最終slugへ日付を付け、なお重複する場合は短い識別子を追加する
meeting-progress-phrases-20261108
meeting-progress-phrases-20261108-a4f2
タイトルにも代表フレーズや利用シーンを含めます。「便利な英語表現」のような抽象的なタイトルを避けることで、記事一覧でも内容を見分けやすくなります。
6. feature imageは記事の要約から作る
画像生成には文字起こし原文ではなく、匿名化済みの「シーン」「代表フレーズの用途」「記事の雰囲気」だけを渡します。横長の比率、統一した色調、画像内に文字やロゴを入れないことなどをプロンプトで指定すると、ブログ全体の見た目をそろえやすくなります。
生成した画像はGhost Admin APIの画像アップロード用エンドポイントへ送信し、返されたURLを記事のfeature_imageへ設定します。ファイル形式、MIME type、ファイルサイズも送信前に検証しておくと安全です。
7. Ghostへは必ずdraftで登録する
Ghost Admin APIへ、本文HTMLとメタデータを送信します。タグ配列ではEnglishを先頭にし、自動公開を防ぐためstatusは常にdraftへ固定します。
{
  "posts": [{
    "title": "会議の進捗確認で使える英語表現:Where do we stand?",
    "slug": "meeting-progress-phrases-20261108",
    "html": "<h2>...</h2>",
    "custom_excerpt": "会議で自然に進捗を確認する表現を解説します。",
    "status": "draft",
    "feature_image": "https://example.com/content/images/.../feature.png",
    "tags": [
      { "name": "English" },
      { "name": "Business English" },
      { "name": "Meetings" }
    ]
  }]
}
投稿に成功した後でだけ、使用したフレーズとタイトルを履歴へ記録します。API通信が失敗した段階で履歴へ追加すると、実際には投稿されていないフレーズまで「使用済み」になるためです。
8. パソコン起動時の自動実行
Linuxであれば、systemdのoneshotサービスとして登録できます。ネットワーク接続後に1回だけ実行し、同時起動をロックファイルで防ぎます。
[Unit]
Description=Create a Ghost draft from a transcript
After=network-online.target
Wants=network-online.target

[Service]
Type=oneshot
WorkingDirectory=/opt/transcript-blog
EnvironmentFile=/opt/transcript-blog/.env
ExecStart=/usr/bin/npm run create:ghost-draft

[Install]
WantedBy=multi-user.target
設定 | 役割 |
|---|---|
| ネットワーク準備処理の完了後に起動する |
| ネットワーク準備処理の起動を要求する |
両方指定 | ネットワークの準備を待ってからサービスを起動する |
APIキーはソースコードへ書かず、権限を制限した.envやOSのシークレット管理機能から読み込みます。起動時にネットワークが不安定な場合に備え、短い間隔で数回だけ再試行し、それでも失敗したらログを残して終了する設計が扱いやすいでしょう。
9. 自動化しても、人の確認工程は残す
最低限、次の項目を自動テストまたは投稿前チェックに含めます。
- フレーズが2つあり、過去履歴と重複していない
- 例文と返答が自然で、和訳と意味が一致している
- タイトルとslugがGhost上でも一意である
- 先頭タグが
Englishである - feature imageのURLが設定されている
- 投稿ステータスが
draftである - 個人名・会社名・連絡先などが残っていない
文章生成を自動化しても、意味の正確さ、公開してよい情報か、サイト全体のトーンに合うかは人が確認します。Ghostのドラフトで止める設計なら、効率化と品質管理を両立できます。
まとめ
音声から直接ブログへ結び付けるのではなく、文字起こしテキストを共通の入力形式にすると、録音環境や音声認識サービスに縛られない仕組みになります。匿名化、構造化生成、重複防止、画像生成、Ghostへのドラフト登録を独立した工程に分けることで、それぞれを安全に改善できます。
最初は手動実行で1件ずつ確認し、記事品質と重複判定が安定してから起動時の自動実行へ移すのがおすすめです。公開だけは自動化せず、人が最終確認する。この境界を守ることで、日々の会話を継続的な英語学習コンテンツへ変えられます。